·
2 Min. Lesezeit
Warum AMD und nicht NVIDIA?
Warum AMD und nicht NVIDIA? Die Frage höre ich oft. Heute bin ich auf der AMD Advancing AI 2026 in San Francisco, ein …
Mehr lesen →Haben Sie Fragen? Wir helfen gerne.
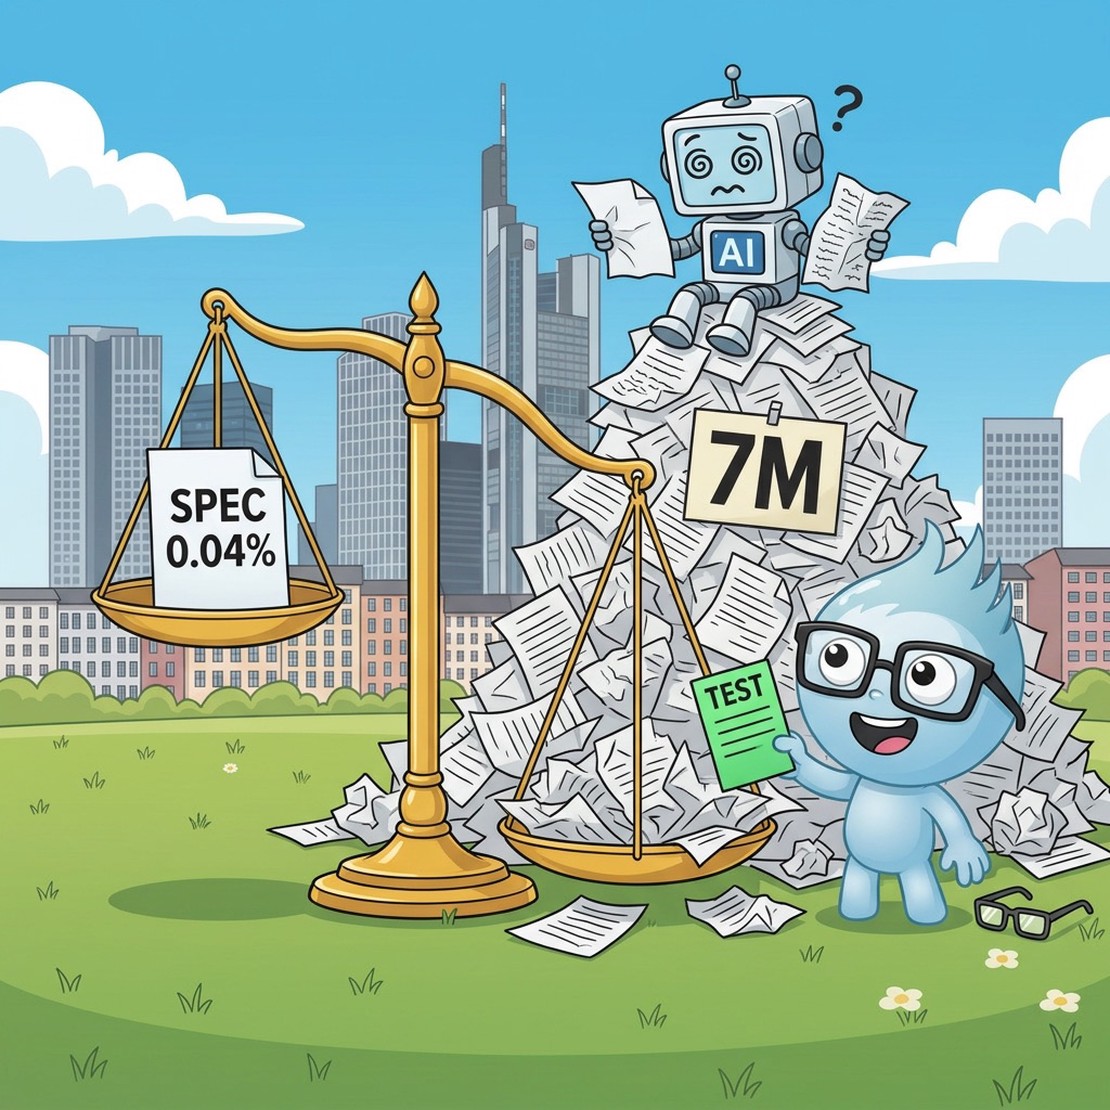
Sollen wir Use Cases umschreiben, damit AI-Modelle sie besser verstehen? Wir haben nachgemessen. Die Spec ist ein Rundungsfehler im Token-Budget. Der blockierte Lauf nicht.
Donnerstagnachmittag, Review unserer Spec-Pipeline. Die Frage: Use Cases, Akzeptanzkriterien und NFRs wurden für Menschen gebaut. Gibt es eine bessere Art, sie für ein Modell zu schreiben?
Zuerst die Zahlen. Der Spec-Text macht etwa 0,04 Prozent der Token aus, die ein sauberer Lauf liest. Ein sauberer Lauf kostet 3,0 Millionen Token. Ein Lauf, den der Agent-Reviewer blockiert, kostet 10,6 Millionen. Von den letzten 252 Läufen waren 72 blockiert. Wir haben die 72 gelesen. Zwei Ursachen, etwa je die Hälfte: Erzählung schlägt Kriterien. Und Vorgaben, die niemand aufschrieb.
Die Spec ist also nicht der Kostenpunkt. Das Missverständnis ist es. Denselben Text umformatieren spart nichts. Ein Modell, das beim ersten Mal richtig versteht, spart 7 Millionen Token pro Block.
Was überspringt das Modell? Akteure. Vorbedingungen. Das Hauptszenario. Sie erzählen die Akzeptanzkriterien als Prosa nach. Stimmen Erzählung und Kriterien überein, bringt die Prosa nichts. Widersprechen sie sich, folgt der Worker der einen Seite, der Reviewer der anderen. Das ist ein Block. Eine unserer Specs nannte dieselbe Baseline dreimal. Das ist keine Klarheit. Das ist eine Spec, die ihren Kriterien nicht traut.
Das Modell braucht keine neue Sprache. Es braucht einen Test, den es bestehen muss, eine Liste dessen, was es lassen soll, und eine klare Andockstelle.
Vier Dinge helfen, in dieser Reihenfolge.
Ein Test oder ein Beispiel, das es ausführen kann. Zwei Kriterien in jener Spec waren Fixture-Paare: diese Eingabe, jene Ausgabe. Diese beiden haben nie einen Block verursacht. Die Prosa-Kriterien schon.
Eine Liste der Grenzen und Nicht-Ziele. Eine Studie zu Design-Constraint-Compliance zeigt: Weniger als die Hälfte der Patches, die ihre Tests bestehen, erfüllen auch die Design-Vorgaben. Bestandene Tests sagen fast nichts. Vorgaben explizit zu nennen senkt die Verstöße. Nicht auf null.
Die Naht. Dateipfad, Funktionssignatur, Aufrufstelle. Unser bekanntester Fehlermodus: „gebaut, aber nie verdrahtet“. Eine typisierte Signatur schlägt jedes Szenario.
Die Invarianten. Welches bestehende Verhalten tragend ist. Das verhindert „eins repariert, den Nachbarn kaputt gemacht“.
Der unbequeme Teil: Unsere Rückverfolgung zeigt auf Tests, die derselbe Agent schrieb. Die Spec prüft sich selbst. Es fehlt ein Holdout-Test vom Spec-Autor, unsichtbar für den Worker. Noch nicht gebaut.
Eine Anmerkung. Wir deckeln Specs bei 10 Kriterien und einem Anliegen. Das bleibt. Der Curse of Instructions ist gemessen: Eine Anweisung: etwa 90 Prozent befolgt. Zehn auf einmal: 44 Prozent, beim besten Modell. Eine reichere Vorlage mit mehr Regeln ist das Gegenteil von Hilfe.
Die neue Form kommt diese Woche, erst beratend. In 30 Tagen vergleichen wir die Blockraten. Bewegt sich nichts, sagen wir es hier.
Use Cases wurden für Menschen gebaut. Das ist nicht ihr Problem. Ihr Problem ist, dass sie sich selbst nicht trauen.
Warum AMD und nicht NVIDIA? Die Frage höre ich oft. Heute bin ich auf der AMD Advancing AI 2026 in San Francisco, ein …
Mehr lesen →
Auf der Agentic Conf 2026 in Hamburg habe ich den Talk von Paul Stack , „Operations follows Development“ gehört und war …
Mehr lesen →
Gedanken von der DynamicsMinds 2026.
Ein Wort zum Rahmen: DynamicsMinds ist eine community-getriebene Konferenz für die …
Mehr lesen →